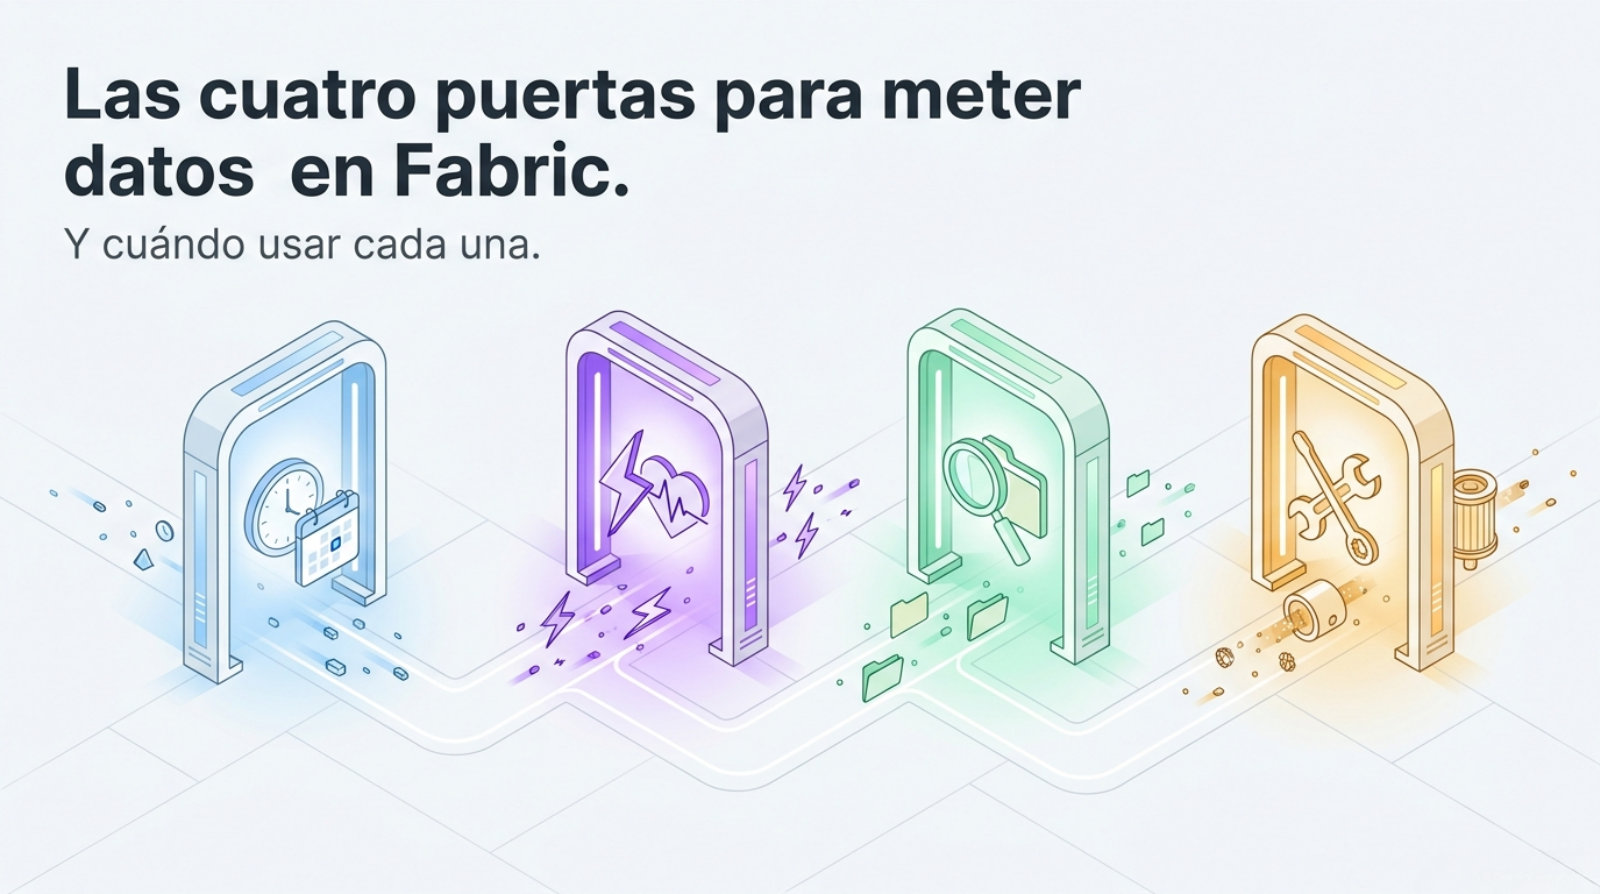
Las cuatro puertas para meter datos en Fabric (y cuándo usar cada una)
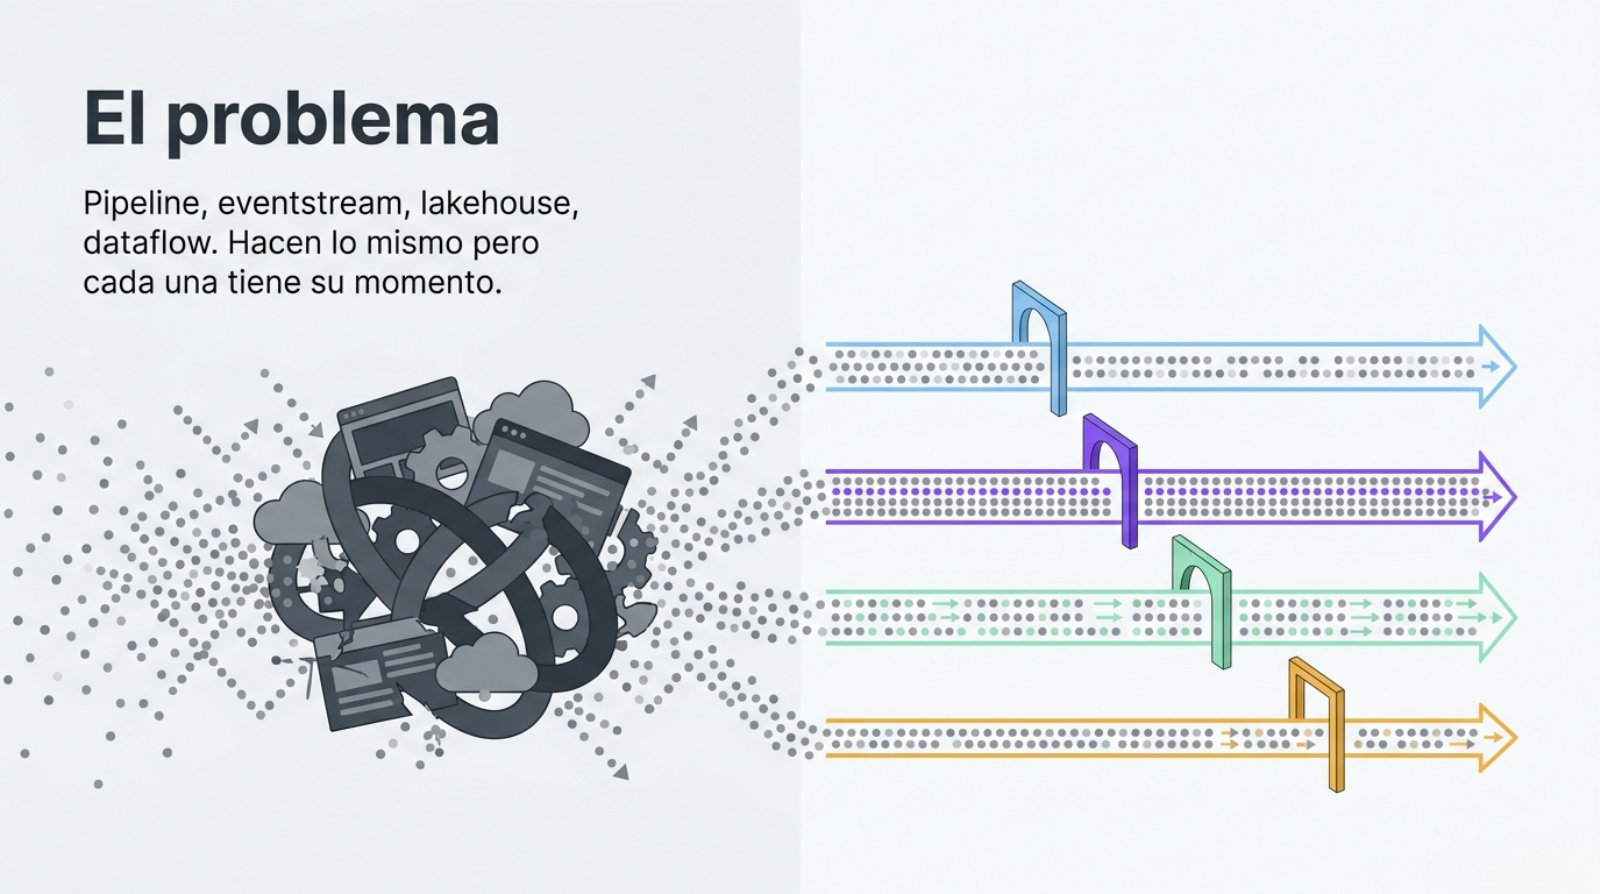
Microsoft Fabric tiene cuatro formas de cargar datos. La documentación las explica por separado, pero no te dice cuándo usar cada una. Pipeline, eventstream, lakehouse con materialized view y dataflow hacen cosas parecidas, pero cada una tiene su momento.
El criterio no es la herramienta. Es la frecuencia y el origen del dato.
01
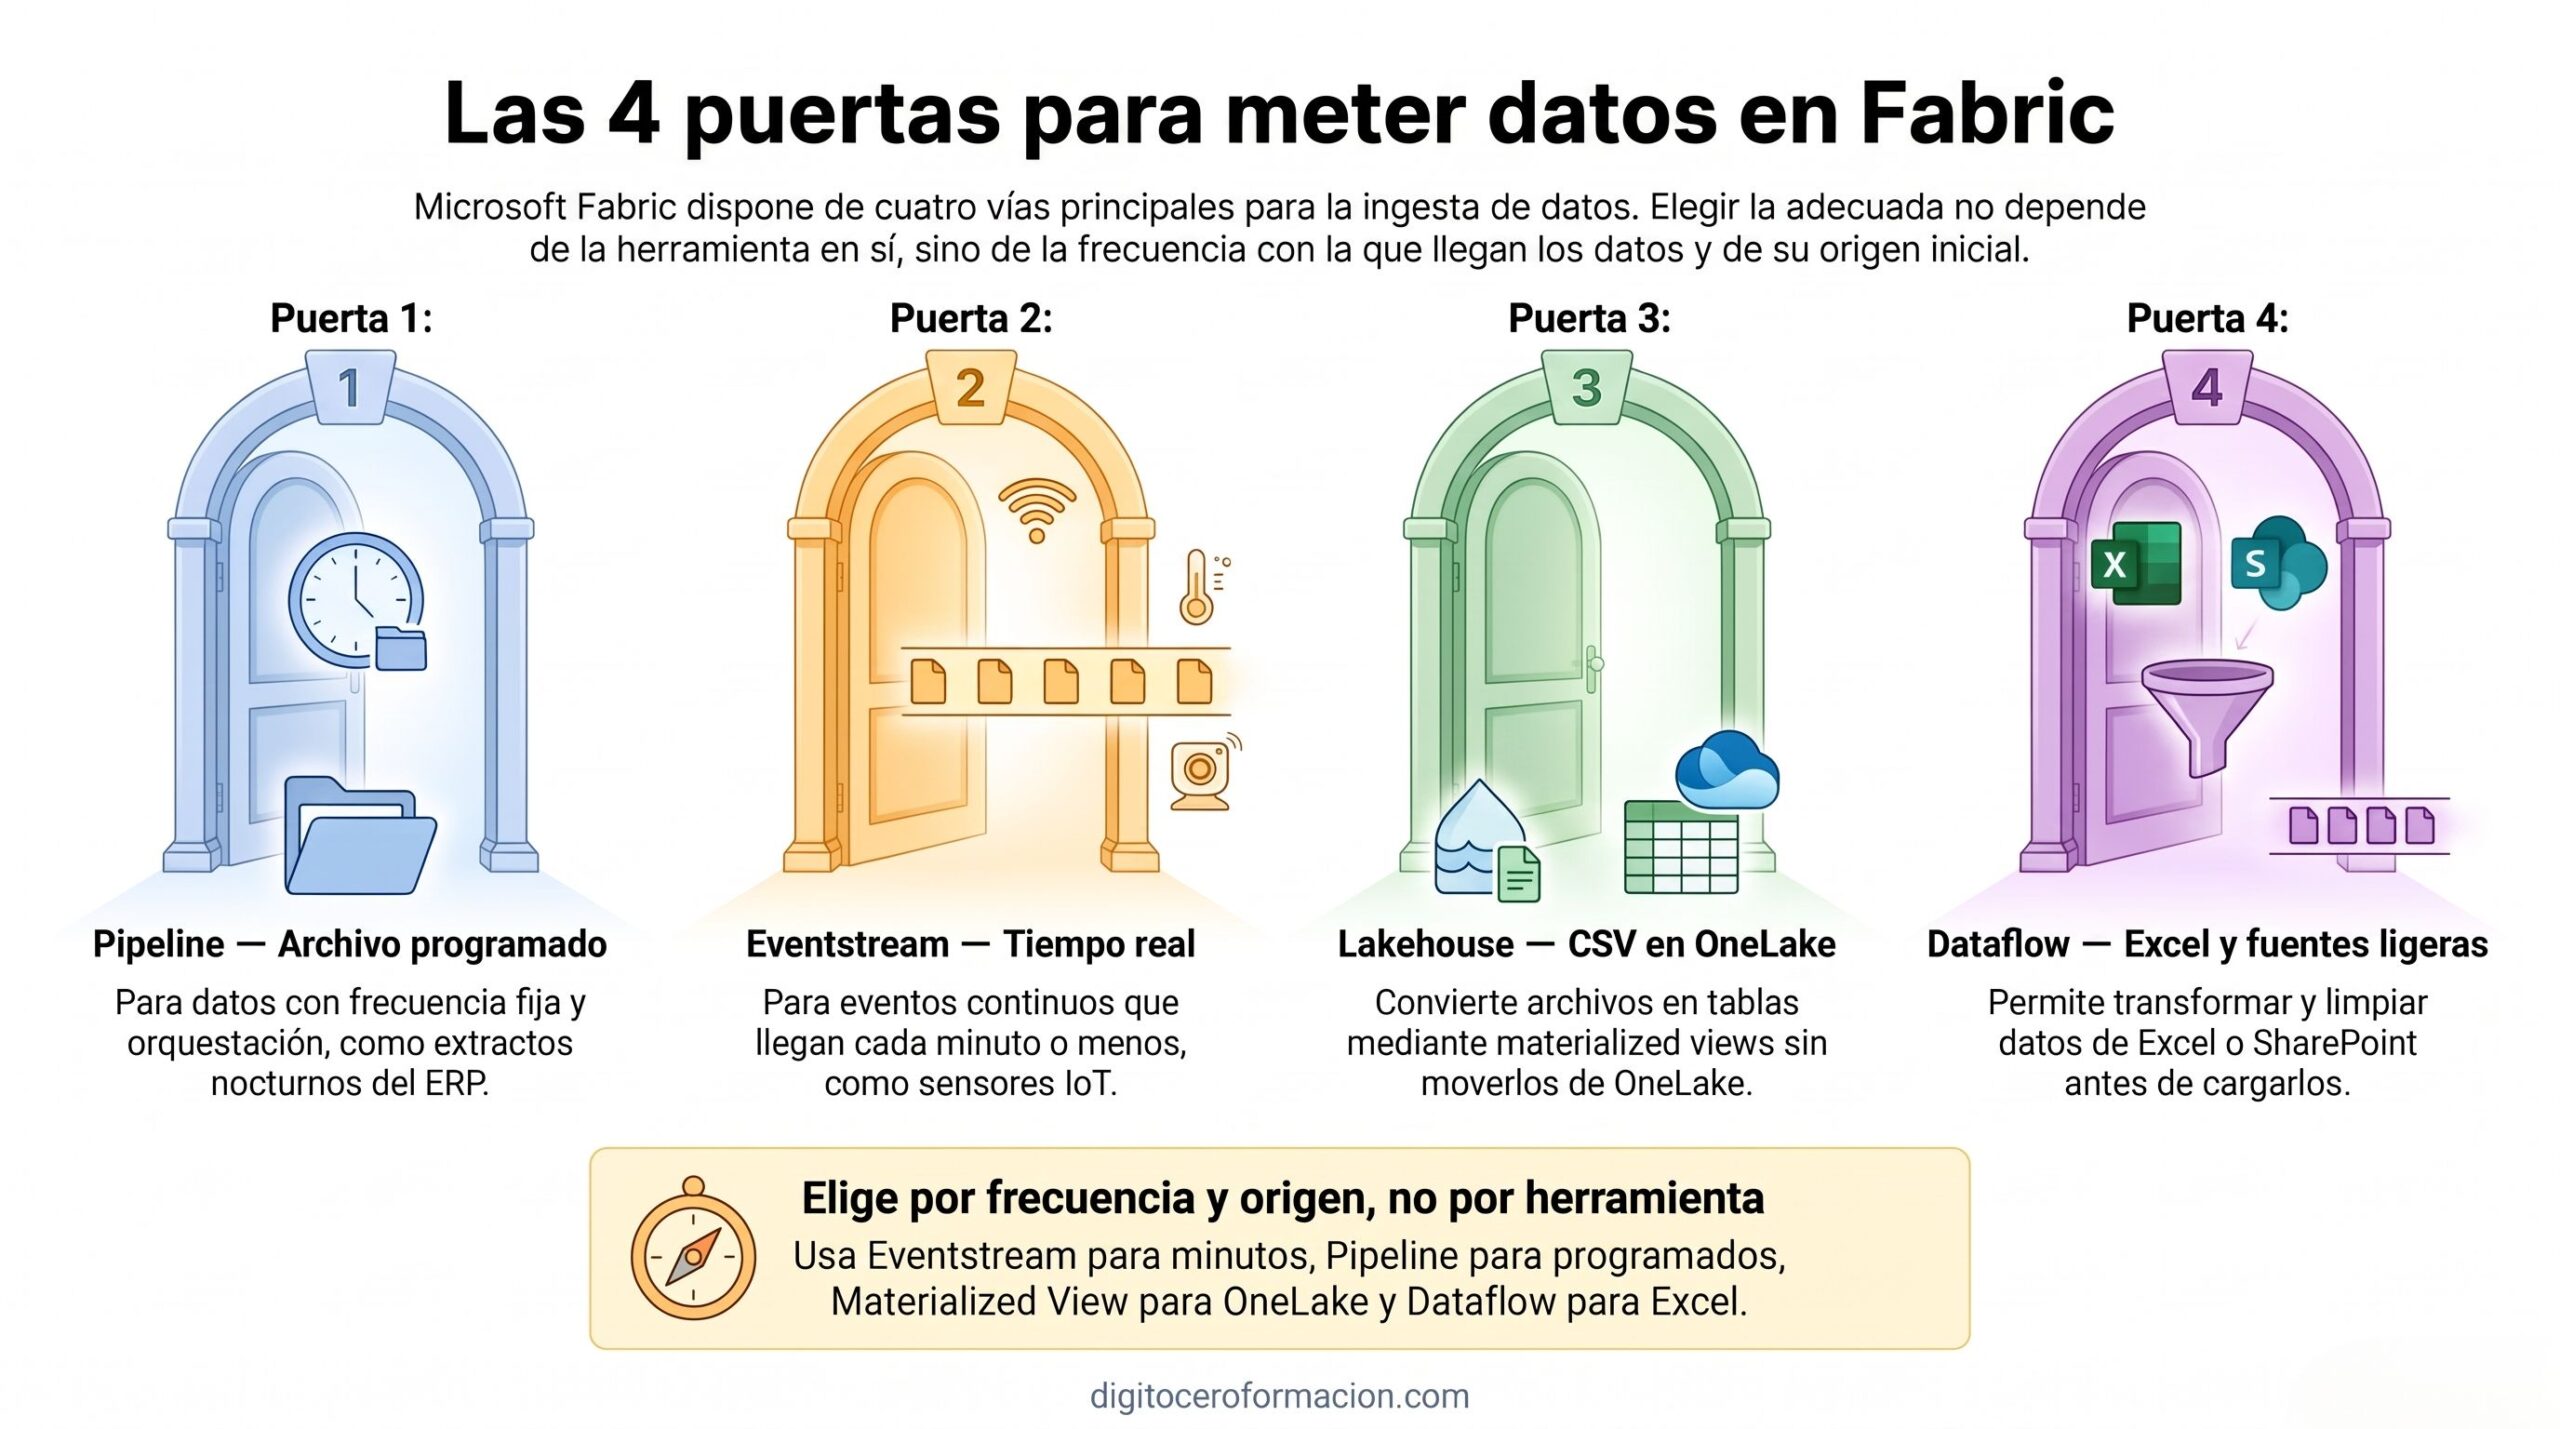
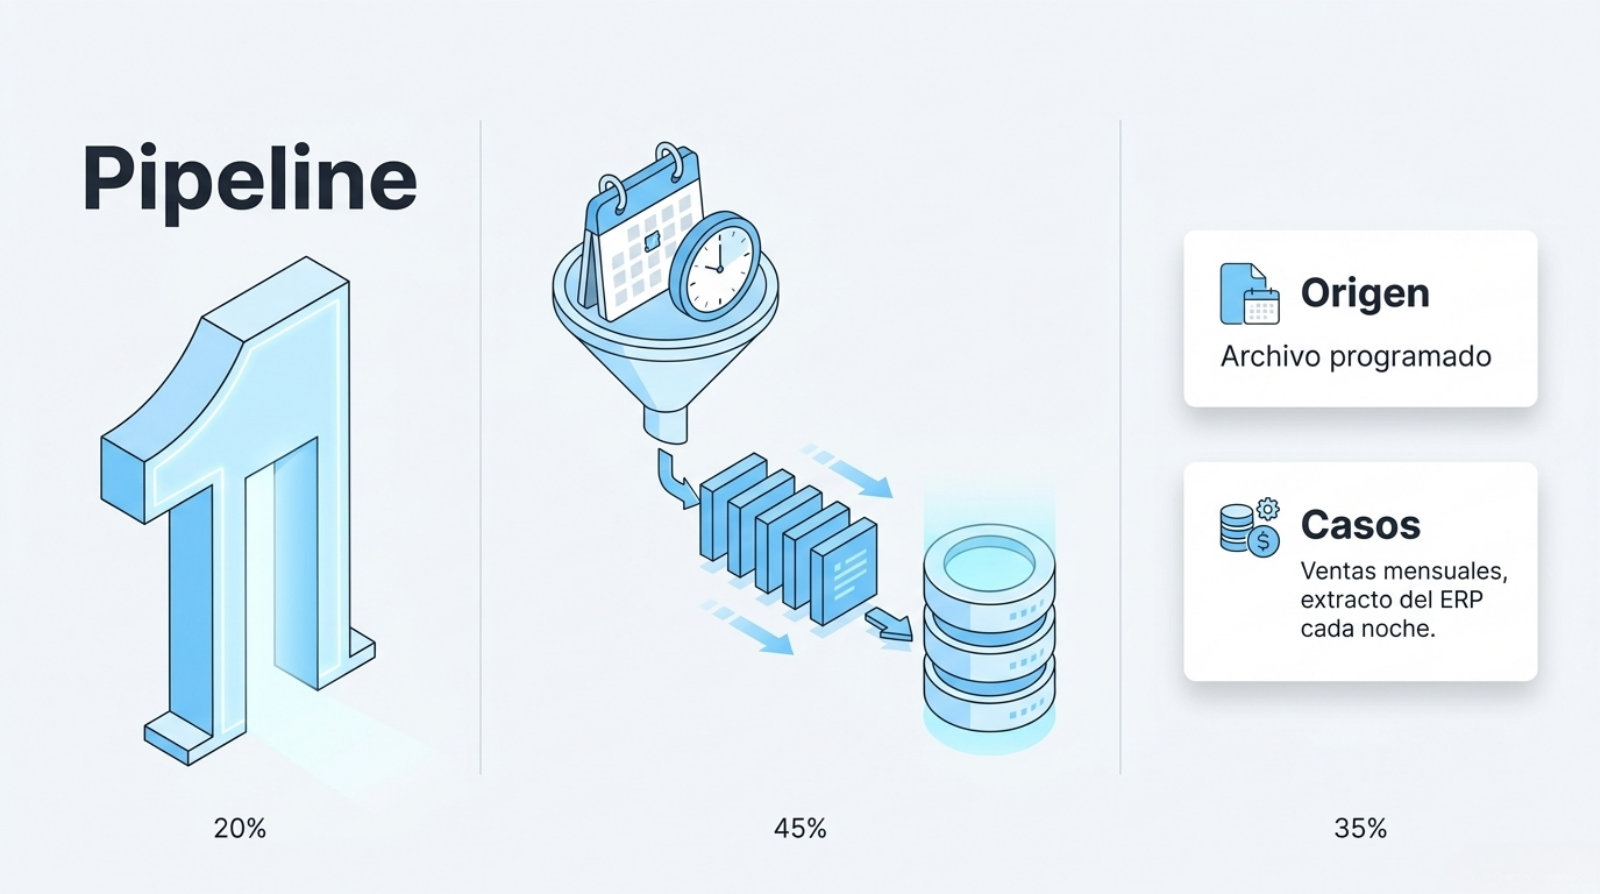
Pipeline: archivo programado
Usa un pipeline cuando el dato llega con una frecuencia conocida y necesitas orquestación.
Imagina que cada noche recibes un archivo de ventas del ERP. O que el primer día de cada mes descargas un extracto bancario. O que cada semana te envían un CSV con el inventario actualizado.
El pipeline se programa, se ejecuta y puede encadenar varias tareas: descargar el archivo, transformarlo, cargarlo en una tabla y enviar un correo si falla.
Sirve para datos que llegan cada hora, cada día o cada mes. No para datos que llegan cada segundo.
02
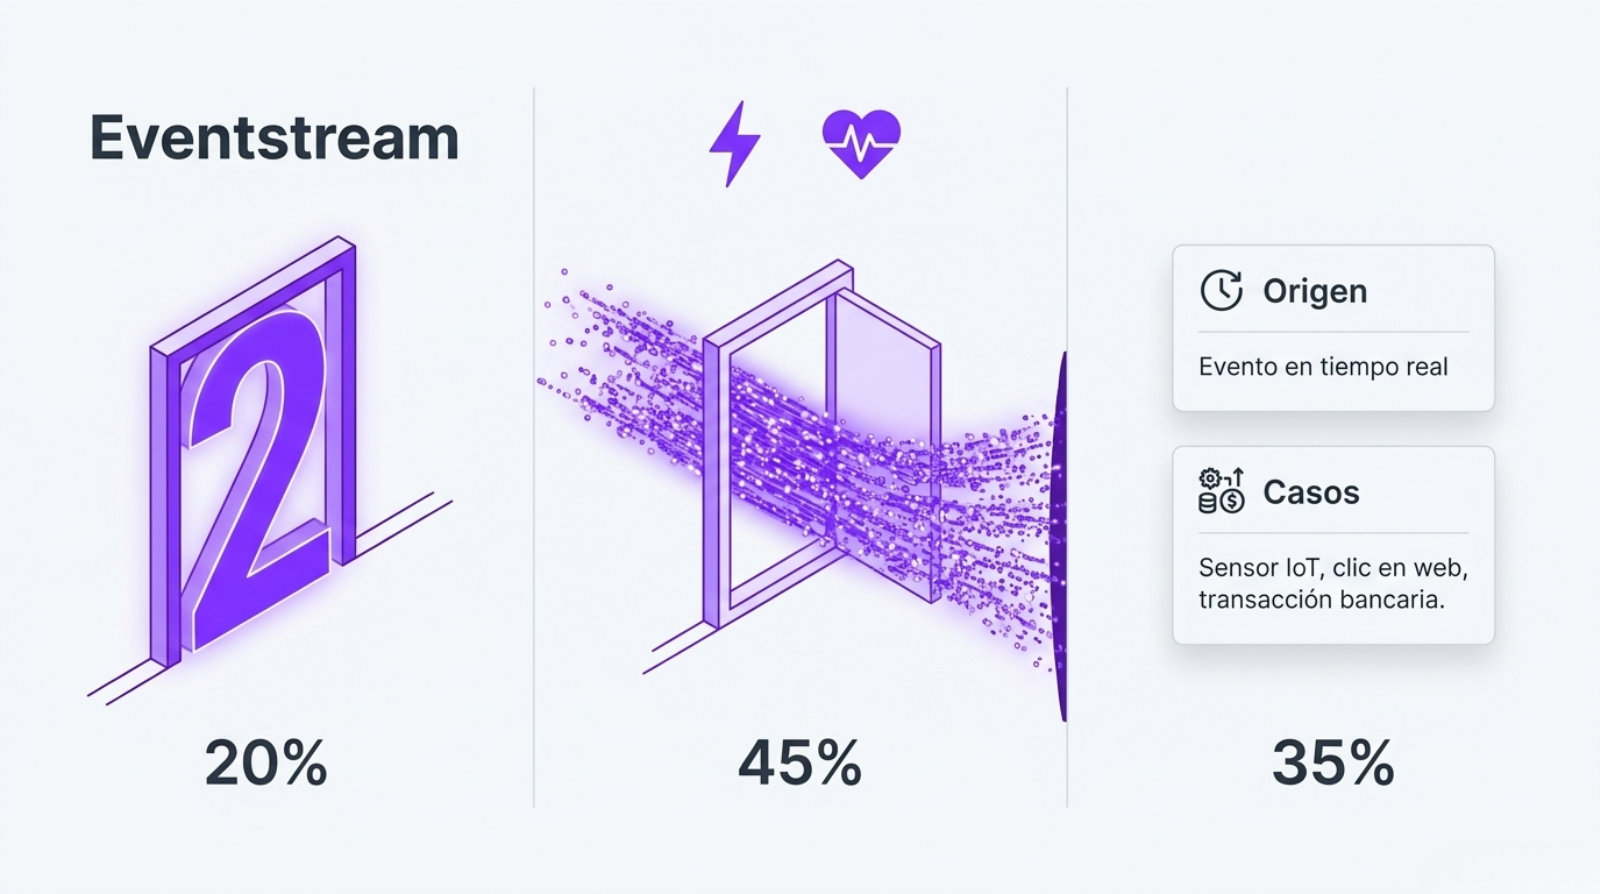
Eventstream: evento en tiempo real
Usa eventstream cuando el dato llega continuamente y necesitas procesarlo al instante.
Piensa en un sensor de temperatura que envía una lectura cada 10 segundos. O en cada clic que hace un usuario en tu web. O en cada transacción que pasa por un TPV.
Eventstream recibe el evento, lo procesa y lo almacena sin esperar a un proceso programado. Es la puerta para streaming.
Si el dato llega cada minuto o menos, eventstream. Si llega cada hora o más, pipeline.
03
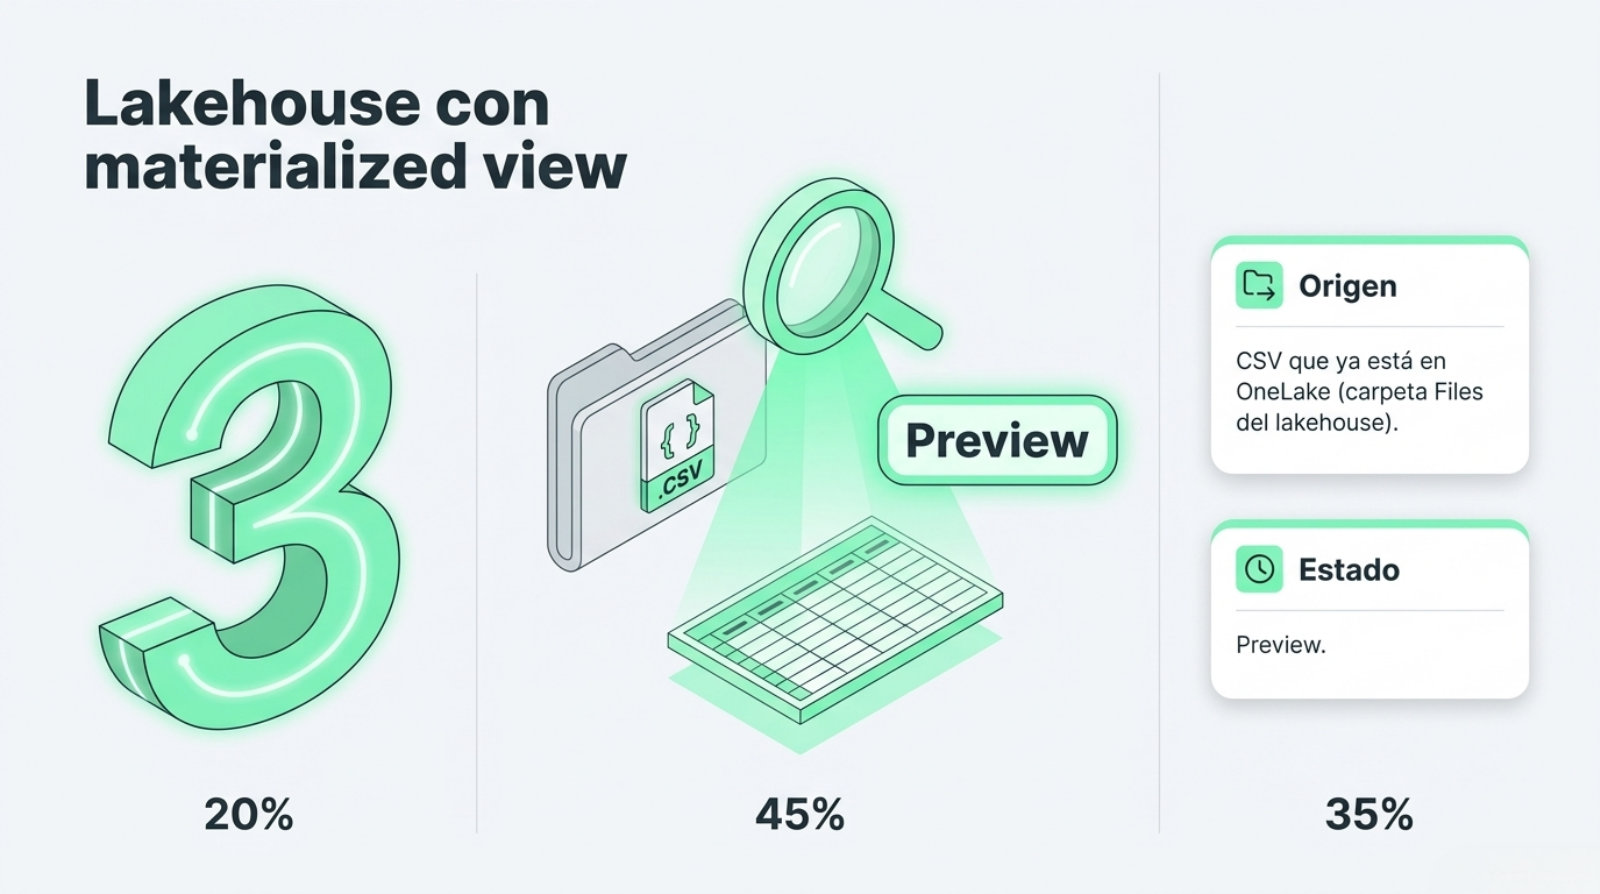
Lakehouse con materialized view: CSV que ya está en OneLake
Usa materialized view cuando el archivo ya está en OneLake y solo necesitas convertirlo en tabla.
Supón que cada mes dejas un CSV en la carpeta Files de tu lakehouse. Ese archivo ya está en OneLake, el almacenamiento de Fabric.
La materialized view lee el archivo y lo convierte en tabla Delta sin moverlo. No necesitas pipeline ni dataflow. Solo apuntas al archivo y Fabric lo materializa.
La ingesta de archivos con materialized views está en preview.
04
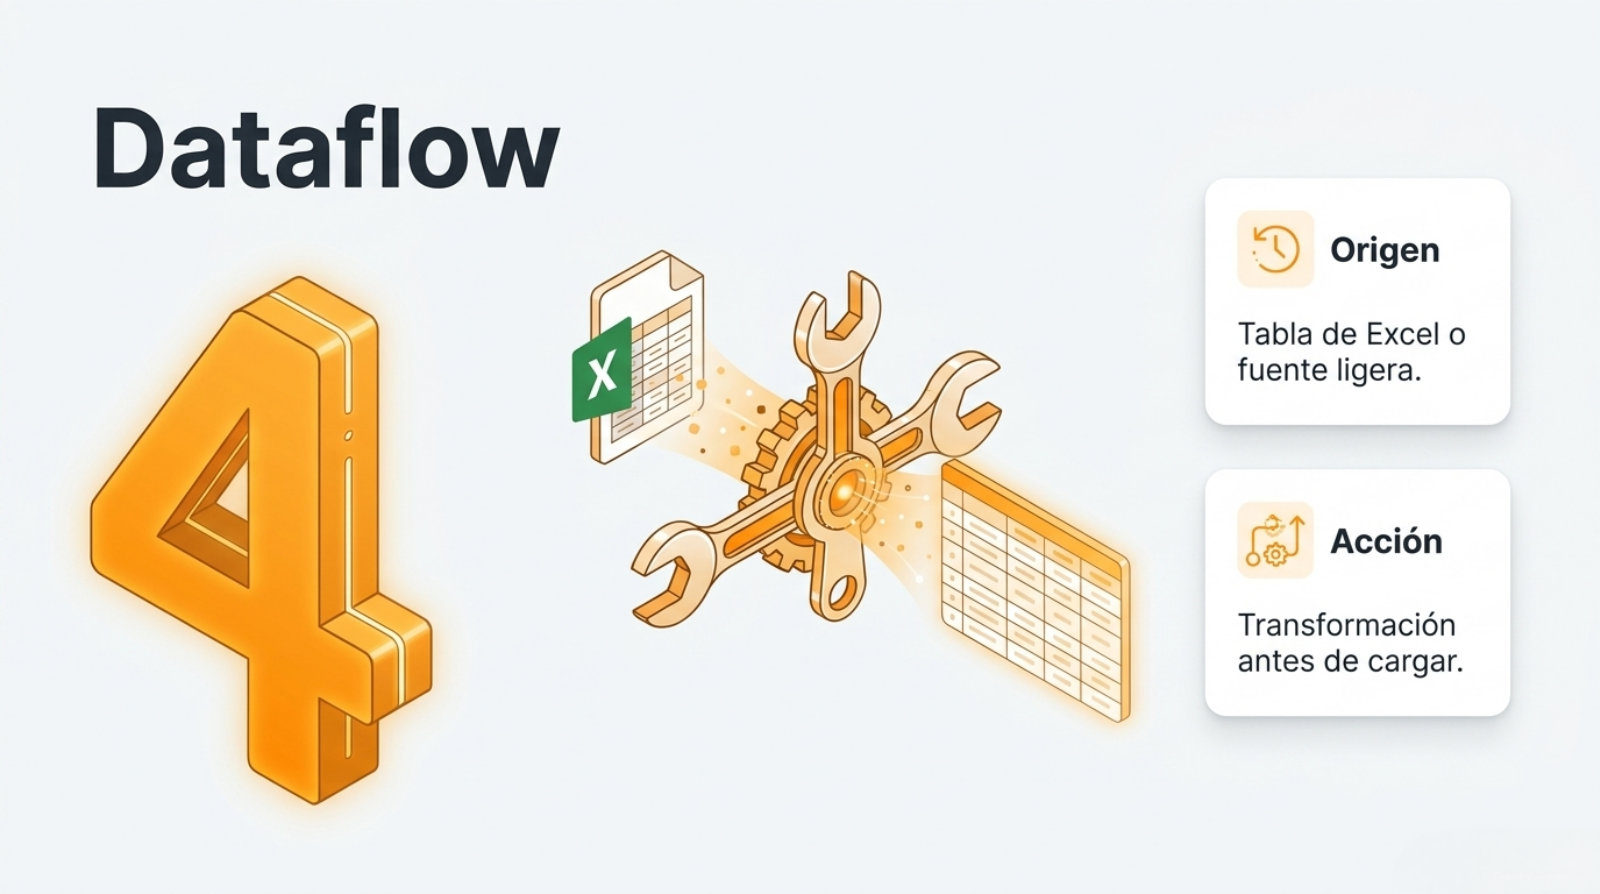
Dataflow: tabla de Excel o fuente ligera que transformas
Usa un dataflow cuando el origen es una tabla de Excel, una lista de SharePoint o cualquier fuente que necesitas transformar antes de cargar.
Imagina que cada mes actualizas un Excel con el presupuesto por departamento. O que tienes una lista de SharePoint con los proyectos activos. O que necesitas cruzar dos tablas pequeñas antes de cargarlas.
El dataflow es Power Query en la nube. Conectas, transformas y cargas. Sin orquestación compleja, sin streaming.
Si el origen es Excel y necesitas limpiarlo, dataflow. Si es un archivo grande que llega programado, pipeline.
05
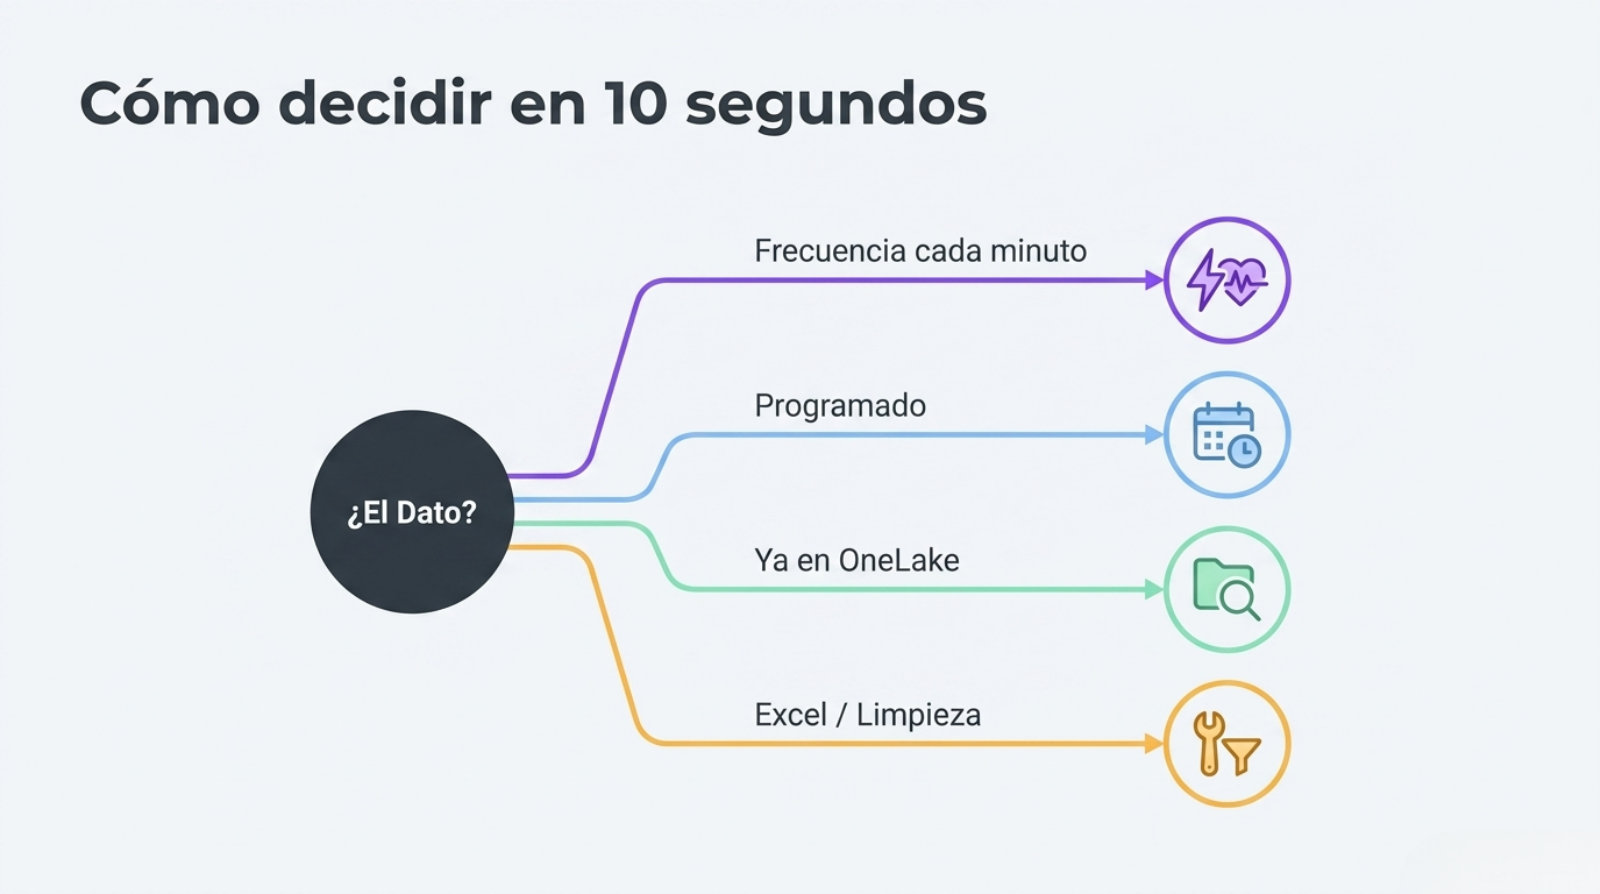
Cómo decidir en 10 segundos
Pregúntate dos cosas: con qué frecuencia llega el dato y dónde está.
Si llega cada minuto o menos → eventstream.
Si llega programado (cada hora, día, semana, mes) → pipeline.
Si ya está en OneLake → materialized view.
Si viene de Excel o necesitas transformarlo antes de cargar → dataflow.
No es la herramienta. Es el caso de uso.
Conclusión
Elegir mal la puerta de entrada en Fabric te cuesta tiempo de desarrollo y mantenimiento. Un archivo mensual no necesita eventstream. Un sensor en tiempo real no puede esperar a un pipeline nocturno.
Mi regla: si el dato llega cada minuto o menos, eventstream. Si llega programado, pipeline. Si ya está en OneLake, materialized view. Si viene de Excel y necesitas transformarlo, dataflow.
Próximo paso: revisa el dato que te cuesta más trabajo meter cada mes. Pregúntate con qué frecuencia llega y dónde está. Elige la puerta que encaje con esa frecuencia.
Únete a la conversación
¿Qué te ha parecido? Comparte tu experiencia o cuéntanos qué proceso repetitivo te gustaría automatizar. Estaré encantado de leer tu comentario.