Microsoft Fabric Data Factory: la guía práctica para automatizar tus datos sin código
Microsoft Fabric Data Factory: la guía práctica para automatizar tus datos sin código
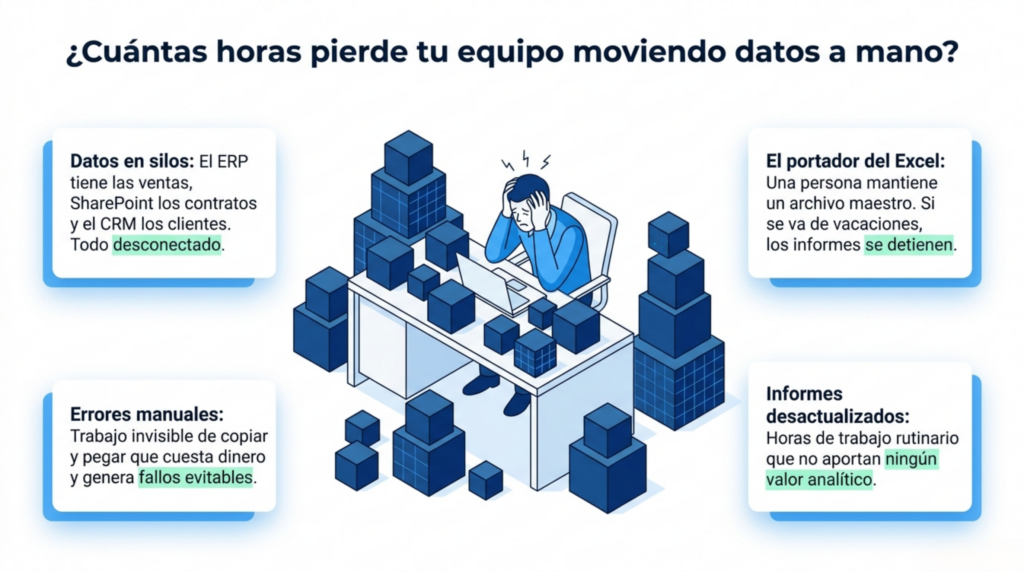
Hay un trabajo invisible que se repite cada día en miles de empresas: alguien, en algún departamento, mueve datos de un sitio a otro a mano. Lo ha hecho siempre. Nadie lo cuestiona. Y ese trabajo invisible cuesta dinero, tiempo y errores evitables.
Esta guía explica qué es Data Factory en Microsoft Fabric, para qué sirve cada uno de sus componentes y cómo puedes empezar a automatizar la ingesta de datos en tu organización hoy mismo — sin necesitar un equipo de ingeniería de datos.
01
El problema que resuelve Data Factory
Antes de hablar de tecnología, hablemos del problema. En la mayoría de empresas hay datos útiles repartidos en silos: el ERP tiene las ventas, SharePoint tiene los contratos, el CRM tiene los clientes, y alguien mantiene un Excel maestro que los une todo. Esa persona — el «portador del Excel» — es el cuello de botella. Si se va de vacaciones, los informes se detienen.
Data Factory existe para romper ese cuello de botella. Es el servicio de integración y transformación de datos dentro de Microsoft Fabric: la herramienta que mueve datos desde donde están hasta donde los necesitas, de forma automática, repetible y monitorizable.
La pregunta que resuelve no es técnica. Es operativa: ¿cómo consigo que los datos correctos estén en el lugar correcto en el momento correcto, sin depender de una persona que lo haga a mano?
02
¿Qué es Data Factory en Microsoft Fabric?
Microsoft Fabric es la plataforma de datos unificada de Microsoft: reúne en un mismo entorno las capacidades de Azure Data Factory, Power BI, Azure Synapse, Azure Data Lake y otras herramientas que antes eran productos separados.
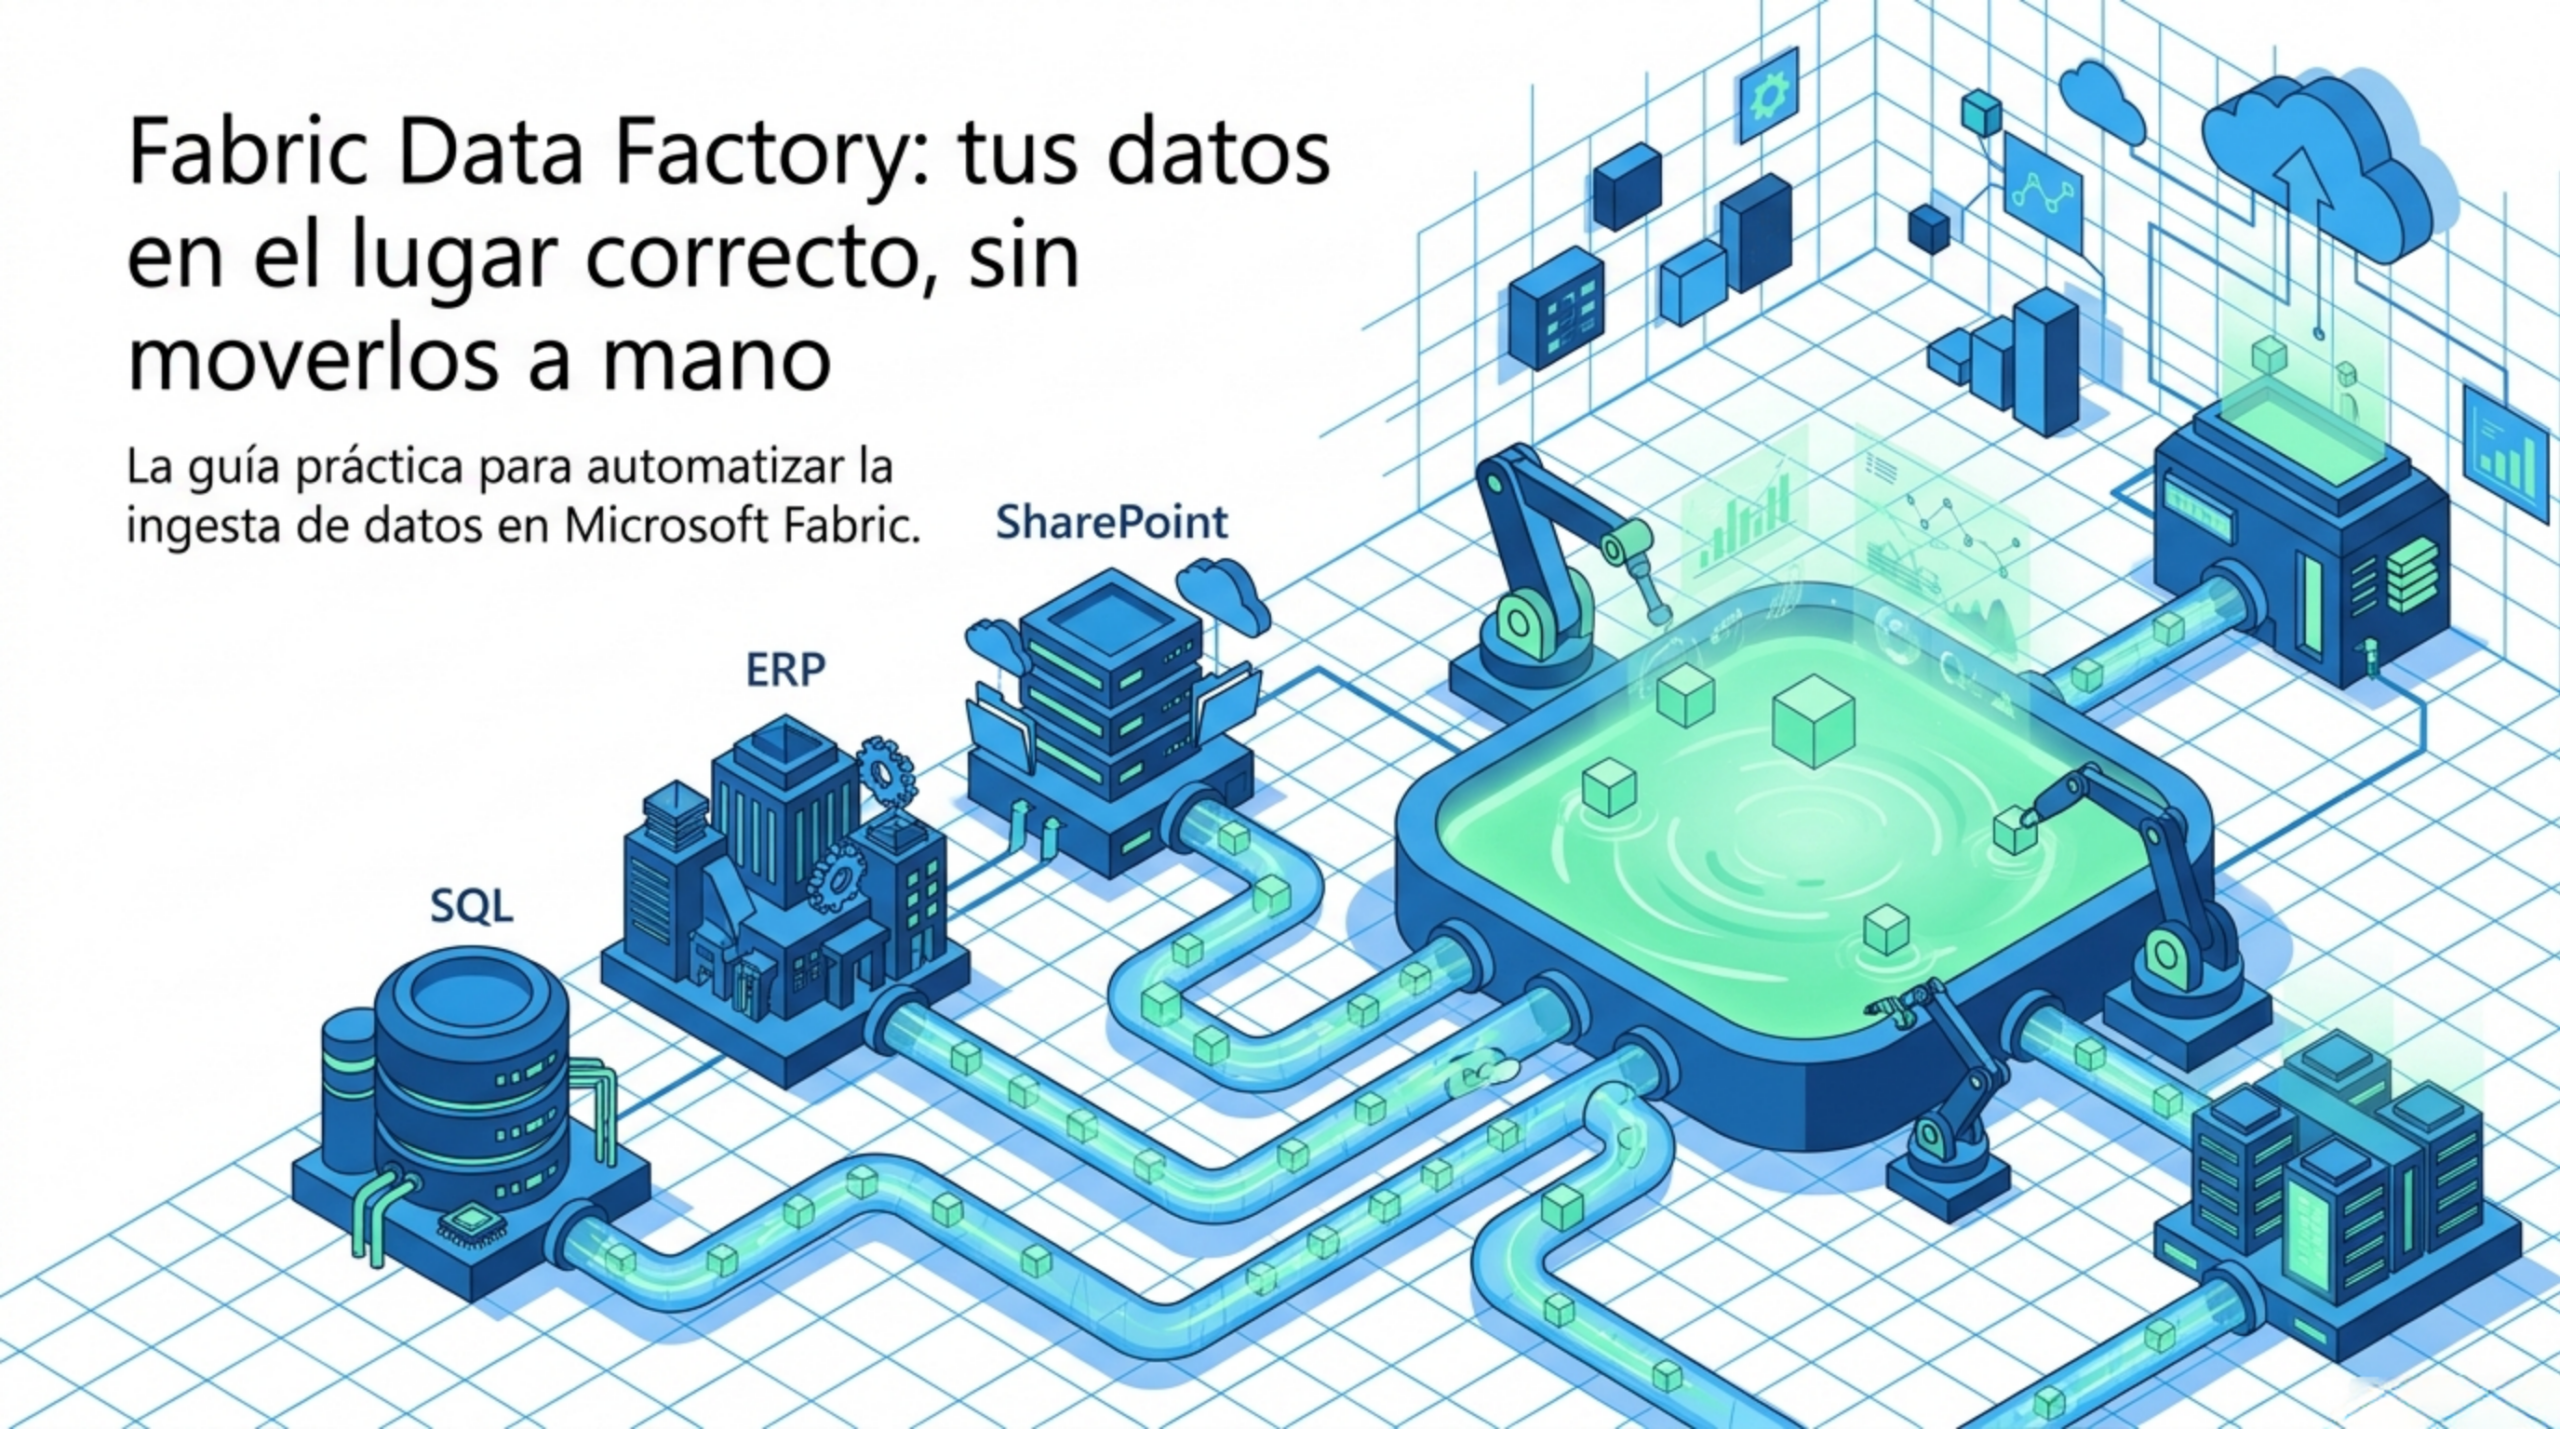
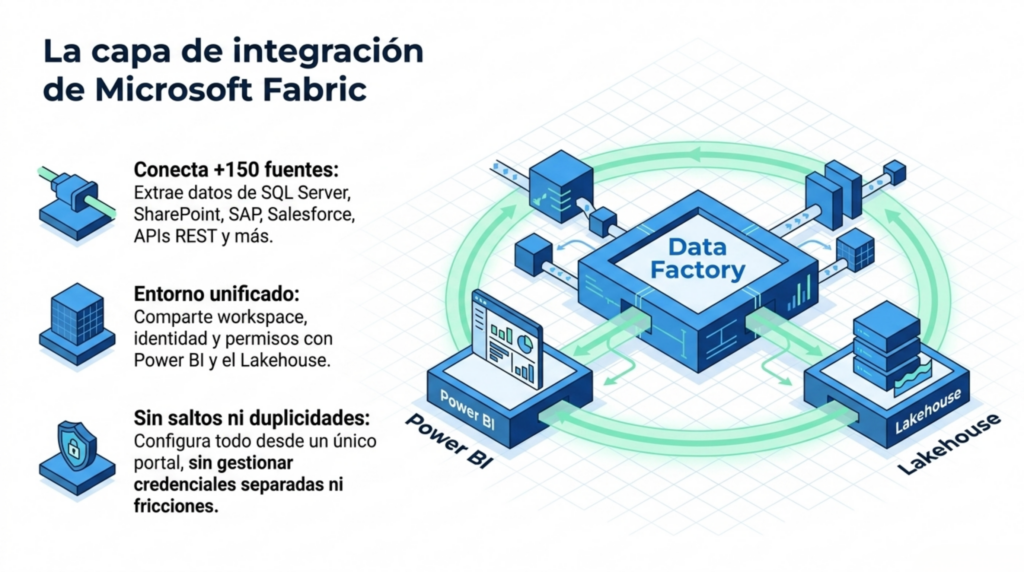
Data Factory es la capa de integración dentro de Fabric. Su función es clara: conectar fuentes de datos heterogéneas, moverlas y transformarlas, y depositarlas en el destino adecuado — generalmente el Lakehouse de Fabric, desde donde Power BI puede consumirlas directamente.
A diferencia de Azure Data Factory clásico, la versión integrada en Fabric comparte workspace, permisos e identidad con el resto de la plataforma. No necesitas gestionar credenciales separadas, ni saltar entre el portal de Azure y el de Fabric. Todo está en el mismo sitio.
03
Los tres componentes clave: Pipelines, Dataflows y Copy Jobs
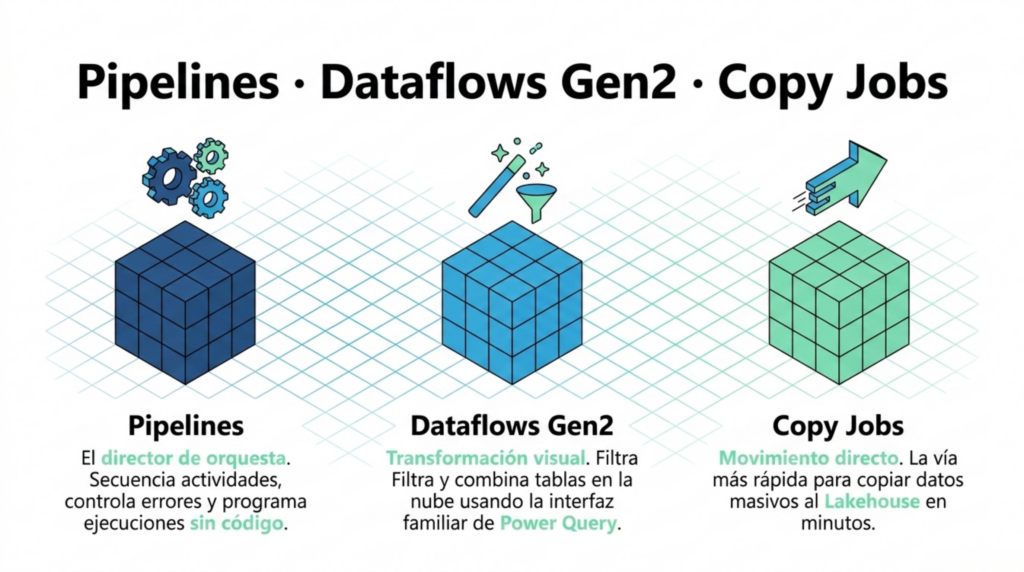
Pipelines: el director de orquesta. Un pipeline es una secuencia de actividades que se ejecutan en orden o en paralelo. Puedes configurar que primero se copien los datos, luego se ejecute una transformación, luego se actualice un dataset de Power BI y finalmente se envíe una notificación por Teams. Todo con control de errores y reintentos automáticos. Se configuran visualmente, sin código.
Dataflows Gen2: transformar sin programar. Si conoces Power Query en Excel o Power BI, ya sabes usar Dataflows. La interfaz es exactamente la misma: conectas a una fuente, aplicas transformaciones (filtrar, combinar tablas, crear columnas calculadas) y defines dónde se guarda el resultado. En el Lakehouse, centralizado, disponible para cualquier informe.
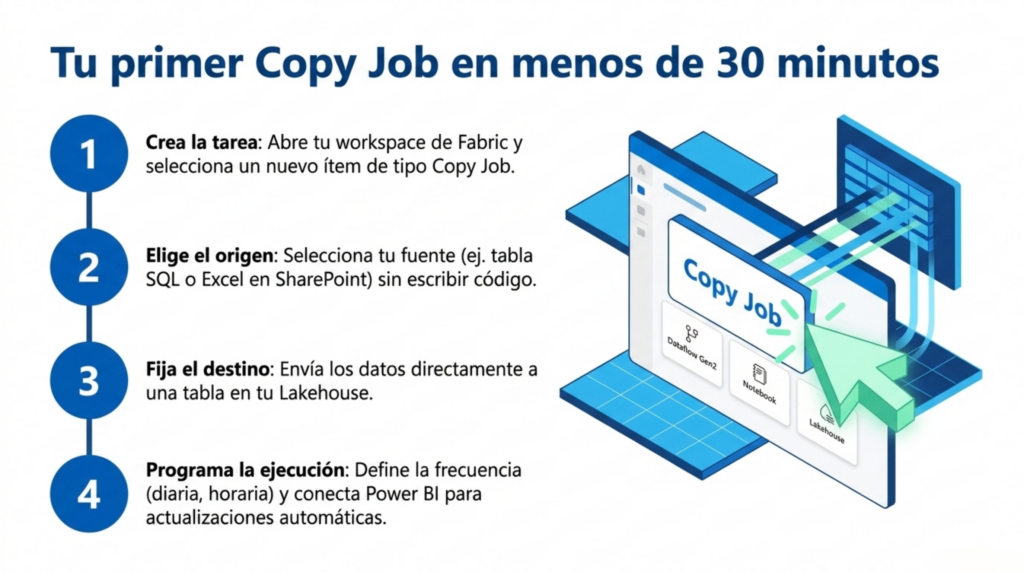
Copy Jobs: cuando solo necesitas mover. Para escenarios simples — copiar una tabla de SQL Server al Lakehouse cada hora, o ingestar un archivo CSV que llega por SFTP — los Copy Jobs son la opción más rápida. Se configuran en minutos y son el punto de entrada perfecto si estás empezando.
04
Cómo funciona por dentro: un ejemplo paso a paso
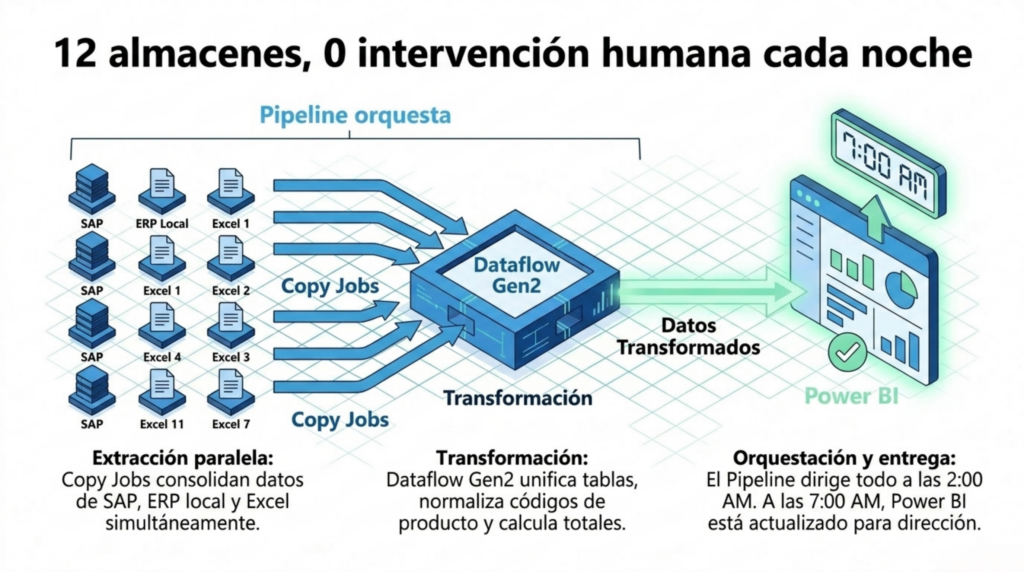
Imaginemos una empresa de distribución con 12 almacenes. Cada almacén tiene su propio sistema: algunos usan SAP, otros un ERP local, y los más pequeños actualizan un Excel en SharePoint. El director de operaciones quiere un informe diario consolidado en Power BI.
Sin Data Factory, alguien exporta cada sistema cada mañana, lo pega en un Excel maestro y actualiza el informe a mano. Dos horas de trabajo que no aportan ningún valor analítico.
Con Data Factory: primero, tres Copy Jobs en paralelo (SAP, ERP local, Excel en SharePoint) depositan los datos en tablas del Lakehouse. Segundo, un Dataflow Gen2 une y normaliza las tres tablas. Tercero, un Pipeline orquesta todo, actualiza el dataset de Power BI y envía un mensaje de Teams al director: «Informe actualizado. 12/12 almacenes con datos al día». El pipeline corre cada noche a las 2:00. A las 7:00, el informe ya está listo sin que nadie haya tocado un teclado.
05
Data Factory en Fabric vs Azure Data Factory clásico
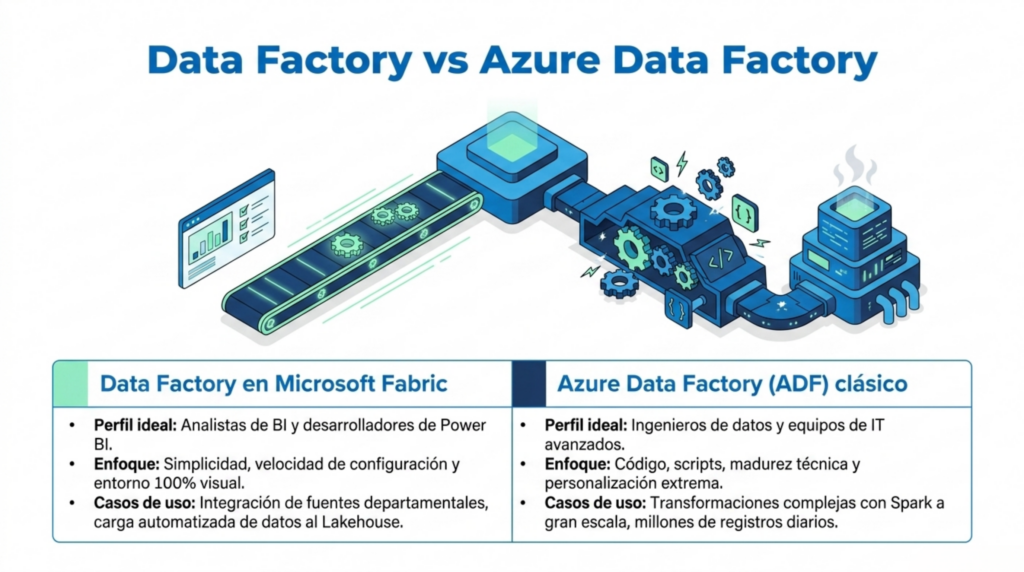
Si ya tienes pipelines en Azure Data Factory (ADF), no los elimines. ADF sigue siendo válido y más maduro para escenarios de ingeniería de datos complejos: transformaciones a gran escala con Spark, integraciones con servicios de Azure muy específicos, o equipos de datos que ya dominan la plataforma.
Data Factory en Fabric está pensado para un perfil diferente: equipos de BI y analistas que quieren automatizar la carga de datos sin depender del equipo de IT, empresas que están adoptando Fabric como plataforma principal, y casos de uso medianos donde la simplicidad y la velocidad de configuración importan más que las capacidades avanzadas de ingeniería.
La regla práctica: si eres analista de datos o Power BI developer y quieres dejar de actualizar cosas a mano, Data Factory en Fabric es tu herramienta. Si eres ingeniero de datos construyendo pipelines de producción para millones de registros diarios, ADF o Spark Notebooks en Fabric pueden ser más adecuados.
Las diapositivas completas
Conclusión
Cómo empezar hoy. El punto de partida más sencillo es un Copy Job. Ve a tu workspace de Fabric, crea un nuevo item de tipo «Copy Job», selecciona la fuente (una tabla en SQL Server o un Excel en SharePoint), elige el destino en tu Lakehouse y configura la frecuencia. Sin código, sin configuraciones complejas.
Una vez que veas los datos fluyendo al Lakehouse, conecta Power BI a esas tablas. Desde ese momento, cada vez que el Copy Job se ejecute, el informe reflejará los datos actualizados automáticamente.
Data Factory en Fabric no es una herramienta para ingenieros de datos. Es una herramienta para cualquier profesional que trabaja con datos y está cansado de moverlos a mano. ¿Cuál sería el primer proceso que automatizarías?
Únete a la conversación
¿Qué te ha parecido? Comparte tu experiencia o cuéntanos qué proceso repetitivo te gustaría automatizar. Estaré encantado de leer tu comentario.